OCLC News 81号
商品情報をはじめ、OCLCに関する様々な情報をご案内致します。
今号はAIとリンクトデータ、特殊言語の目録作成におけるAIなどの話題をお届けします。
『OCLC News』一覧 >
目次
―OCLCのリーダーたちが知見や経験を共有するブログ Nextより(英語記事翻訳)―
AIにはコンテキストが必要です。リンクトデータがそれを提供します。
2026年8月3日 – アクセル・カシュテ
人工知能はいまや、最先端技術に関する議論の中心となっています。会議の場でも、ニュースの見出しでも、製品のロードマップにおいても、AIは至る所に溢れています。一方で、かつて大きな注目を集めていたリンクトデータは、その存在感が薄れているように見えます。
しかし、そのような認識は重大な誤解を招く恐れがあります。AIはリンクトデータに取って代わるものではありません。むしろ、構造化され、相互に連携したデータがAIにとって如何に不可欠であるかを浮かび上がらせているのです。
AIとリンクトデータは優先度で競合する事項ではありません。相互に融合しつつある技術であり、共に進化し、多くの場合、互いをより良いものへと高めているのです。
その関係性を理解するには、まずAIシステムが実際にどのように機能するのかを知ることから始めなければなりません。
AIは学習の質に左右される
現代のAIシステムのほとんど、特に機械学習やニューラルネットワーク(人間の脳の仕組みを模倣した機械学習モデル)に基づくものは、「学習」と「推論」という2つの段階を経て動作します。
学習段階では、モデルは大量のデータから学習します。これらの例を通じて、システムはパターンの仕組み、言語の流れ、概念間の関係性がどのように現れるかを学びます。学習が完了すると、モデルは推論段階に移り、そこで学んだことを新しい状況に応用します。
これは強力な機能ですが、問題も伴います。
学習には大量のデータが必要であり、量と同様に質も重要です。基礎となる情報に矛盾があったり、不完全だったり、構造が不適切だったりすると、モデルは欠陥のある例から学習することになります。複数のソースからのデータを組み合わせると、そうした不整合が倍増する可能性があります。
導入後、AIシステムは実証が困難な結果を生成することがあります。システムが確信を持って誤った出力を生成する「ハルシネーション」は、依然として解消されない課題となっています。
これらすべてが、ある核心的な問いへとつながります。それは、「AIが処理するためのより良い知識を、どうすれば提供できるか」ということです。
体系化された知識は、AIの学習方法を向上させる
ここで、リンクトデータが極めて重要な役割を果たします。
リンクトデータは、構造化された関係を通じて情報を整理します。データを孤立した記録として扱うのではなく、実体とそれらの間の関係を結びつけ、機械がより容易に解釈できる知識のネットワークを形成します。
図書館はかねてより、メタデータを通じてこの種の構造を構築してきました。MARCのようなフォーマットは、図書、著者、主題、版に関する豊富な記述を記録しています。このデータがリンクトデータへと進化するにつれ、単なる記述にとどまらなくなります。相互に接続され、大規模なレベルで機械が理解できるものとなるのです。
OCLCの経験によれば、構造化されたメタデータを学習の入力データとして使用することで、大きな違いが生まれます。実体間の関係がすでに定義されている場合、モデルは生のパターンからそれほど多くのことを推論する必要がありません。構造はデータに組み込まれているからです。
これにより、学習の効率が向上し、有用な結果を得るために必要な計算負荷を軽減することができます。
簡単に言えば、知識が整理されていればいるほど、AIシステムはその知識から学習しやすくなるのです。
リンクトデータはAIの出力精度も向上させる
そのメリットは学習段階にとどまりません。リンクトデータは、推論の過程でAIの出力を検証する手段も提供します。
注目を集めているアプローチの一つが、ナレッジグラフを活用した「検索補助生成(Retrieval-Augmented Generation)」です。システムは、モデルの出力だけに頼るのではなく、信頼できる構造化された知識基盤と照らし合わせて結果を確認することができます。
OCLCにおけるおすすめ機能の開発では、AIが生成した提案をWorldCatと照合して、タイトルが存在することや関係性が正確であることを確認した上で、結果を返しています。
これにより、信頼性が大幅に向上します。誤った結果が生成される可能性が低減され、出力がどのように生成されたかについて、より明確で追跡可能な根拠が提供されます。
AIシステムは、パターン認識のみに依存するのではなく、検証可能な知識に基づいて応答を構築することができます。
継続的改善のサイクル
AIとリンクトデータの関係は、継続的なサイクルとして捉えると、さらに強力なものとなります。
AIは既存のメタデータを分析し、パターンや不備、あるいは欠落している関連性を特定することができます。その知見を活用して基盤となるデータを強化し、ナレッジグラフを充実させることができます。
こうして改善されたデータが、次のトレーニングの基盤となります。
このプロセスは、トレーニング、推論、検証、改善という流れで繰り返されます。
OCLCでは、WorldCatにおけるAIによる重複排除プロセスなど、この反復的なアプローチがすでに具体化しつつあります。今年初め、WorldCat内の英語のプリント版図書のみを対象とした試験運用を完了し、新たに検出された5,000,000件の重複レコードを統合しました。英語のプリント版図書は、WorldCatにおける重複レコードの最大のカテゴリーであり、これまでの機械学習による重複排除の取り組みにおいて、最も厳格にテストされ、改善されてきたフォーマットでもあります。結果の分析は現在も進行中ですが、1つ明らかなことがあります。それは、AIの出力を構造化データと照合することが可能であり、その結果がデータ自体の精緻化と拡張に役立つということです。時間の経過とともに、データとモデルの双方が共に改善されていきます。
ここで、「技術の融合」という概念が実用的な意味を持ちます。AIとリンクトデータは、単に並行して進化しているだけではありません。互いが互いの有効性を積極的に高め合っているのです。
リンクトデータが依然として重要な理由
現在、AIが注目を集めているため、他のあらゆる技術もそれに適応しなければ淘汰されてしまうかのように思われがちです。しかし、AIとリンクトデータの関係からは、別のことが示唆されています。
AIは強力ですが、その潜在能力を最大限に引き出すには、構造化され、相互に関連付けられた知識が不可欠です。リンクトデータは、機械が理解し、検証し、さらに発展させることができる形で情報を整理することで、その基盤を提供します。
豊富なメタデータを管理している組織にとって、これは大きな強みとなります。そのデータは、単にリソースを記述するだけにとどまりません。より正確で、効率的かつ信頼性の高いAIを実現するのです。
今後の展望
AIは今日、注目を集める技術ですが、その効果を発揮するには、信頼性が高く、適切に連携されたデータが不可欠です。リンクトデータは、そのコンテキストを提供します。
OCLCにおいて、これは単なる理論上の関係ではありません。これは積極的な投資が行われている分野であり、リンクトデータとAIが共に進化し、時間とともに改善され続けています。
これらの技術は互いに置き換わるのではなく、融合しつつあります。そして、両者が相まって、知識をいかにしてより効果的に整理し、理解し、共有できるかを形成しつつあります。
このブログは、2025年にカザフスタンのアスタナで開催されたIFLA WLIC会議で初公開されたプレゼンテーション「Building Intelligence: Practical library applications of AI and Linked Data at OCLC」の内容に基づいています。プレゼンテーションの全編録画はこちらからご覧いただけます。
目次へ戻る▲
原文はこちらから>>
―OCLC ResearchのブログHanging Togetherより (英語記事翻訳)―
特殊ケースではない:アラビア語メタデータワークフローを通じてAIの可能性を理解する
2026年5月6日 – オマール・ファルホウド
EMEA地域セールスマネージャーであり、今回のゲスト執筆者でもある同僚のオマール・ファルホウド氏には、アラビア語メタデータワークフローにおけるAIの活用可能性、および留意すべきリスクと制約について、貴重なご意見をいただきました。メタデータワークフローへのAI導入に関する詳細は、OCLCのブログシリーズをご覧ください。
OCLC Researchブログの最近の議論では、人工知能(AI)が目録作成やメタデータワークフローをどのように変革し始めているか、特に滞貨の解消や効率性の向上においてその影響が顕著に表れています。しかし、こうした議論は、英語のメタデータが主流となっている環境を前提としている場合が多いのが現状です。中東、特にアラビア語圏の図書館の視点を取り入れることで、多言語環境、文字体系の多様性、表現上の問題など、これまでとは異なる状況が浮かび上がってきます。
アラビア語のメタデータワークフローは、特殊なケースではありません。これらは、その地域の大学図書館、国立図書館、公共図書館における日常的な運用状況を反映しています。そのため、自動化されたワークフローと人間の監視との相互作用を含め、図書館システムにおけるAIの可能性と限界の両方を検証するための貴重な視点を提供します。
多言語ワークフローとしてのアラビア語メタデータ
中東の多くの図書館における目録作成は、本質的に多言語対応です。レコードは通常アラビア語と英語で作成され、場合によってはフランス語でも作成されます。そのため、各言語内での一貫性を維持すると同時に、異なる文字体系間での整合性を確保するという二重の責任が生じます。
ConnexionクライアントなどのOCLC目録環境では、この多言語対応は書誌レコードの構造に組み込まれています。アラビア文字のフィールドは、ALA-LCなどの確立された翻字基準に従って、ローマ字表記の対応するフィールドとペアになっています。したがって、1つの知的著作が、時間を経ても整合性が維持される複数の表示を並列させて存在しています。
技術的な考慮事項もあります。アラビア語での目録作成は、適切な入力方法、キーボード構成、およびMARC環境における非ラテン文字のサポートに依存します。これらのインフラ要素は、効率性とデータ品質の両方に直接影響を与えます。
翻字はこのワークフローの中核を成します。システムは自動的なサポートを提供するものの、出力結果にはしばしば手動による修正が必要となります。アラビア語は文脈に非常に敏感であり、綴りのわずかな違いが意味を大きく変えてしまう可能性があるのです。
翻字は依然として改善の余地が大きい分野です。現在の手法は主に規則に基づくものです。AIモデル、特に質の高いバイリンガルコーパスで学習させたモデルは、より文脈に即した翻字候補を提供できる可能性がありますが、これらのモデルも検証が必要となるため、人間の監視の必要性は依然として高いのです。
発見に関する期待と標準化の実践
発見という側面では、ユーザーの期待がさらに複雑さを増す要因となります。アラビア語圏のユーザーは、検索システムが正確な入力を必要とせず、綴りの違いをシームレスに処理することを期待しています。
WorldCat Discoveryの最近の機能強化は、規則に基づく正規化によってユーザーの期待がどのように実現されているかを示しています。これには、発音記号と非発音記号を同等に扱うこと、文字の異体字(アレフの異なる形など)を正規化すること、「ال」のような接頭辞を処理すること、および伸長文字を無視することが含まれます。ソート規則もアラビア語の言語慣習を反映するように調整されています。
一見シンプルな検索機能に見えるものの、その基盤となっているのは、綿密に設計・テストされた正規化ルールです。これらのルールは決定論的かつ透明性が高く、実際の利用パターンに基づいて時間をかけて改良されています。
これはAIにとって重要なベンチマークです。メタデータの作成や発見に対するAI主導のアプローチは、このレベルの言語精度に匹敵するか、それを上回る必要があります。さらに、AIは目録作成ワークフローに正規化を拡張できる可能性があります。ディスカバリーシステムはクエリ時に正規化を行いますが、目録レコード自体には、特に旧ルールで作成されたデータにおいて、しばしば不整合が残ります。機械学習モデルは、大規模データセット全体にわたる異形式の識別と整合に役立つ可能性があります。
ローカルワークフローから共有ディスカバリーインフラまで
アラビア語コレクションがグローバルな検索システムの中でどのように位置づけられるかという点においても、より広範な変化が起こっています。WorldCatのインフラ上に構築された共有アラビア語目録のような集約型ディスカバリーイニシアチブ (訳者注: Arabic Discovery Catalogをご参照ください) は、孤立したローカルシステムから、より統合され、可視化されたエコシステムへの移行を反映しています。
中東各地の図書館の現地調査から、共通の懸念事項が指摘されています。それは、アラビア語研究の国際的な認知度です。検索の断片化とメタデータの不整合により、アクセスと表示は依然として制限されています。
戦略的な観点から見ると、これは「集合的コレクション (Collective collection)」に関するより広範な議論や、資料発見の改善における共有インフラの役割と合致します。AIをこうしたインフラと組み合わせることで、メタデータの一貫性を大幅に向上させ、複数機関を横断した連携を支援できる可能性があるのです。
リスクと制限
こうした機会がある一方で、アラビア語メタデータワークフローにおけるAIの利用が、重要な問題をいくつか引き起こしています。
- 言語バイアスは依然として大きな問題である。多くのAIモデルは主に英語のデータに基づいて学習されているため、アラビア語での性能にばらつきが生じる。これは、AIシステムが既存の言語的・文化的不均衡を再現しているという、より広範な批判を反映している。
- 翻字は新たなリスクをもたらす。ルールベースのシステムは予測可能だが、AI駆動型のアプローチでは、標準化が難しい多様な出力が生じる可能性がある。このような多様性は、典拠管理との一貫性を損なう恐れがある。
- また、意味のニュアンスが失われるリスクもある。アラビア語の固有名詞や用語には、自動処理システムでは捉えきれない文化的・文脈的な意味合いが含まれている場合が多い事が理由。
- 正規化そのものには慎重なアプローチが必要。ルールベースの正規化は制御可能で透明性が高い一方、AIシステムは過剰に正規化を行い、データ内の意味のある差異を取り除いてしまう可能性がある。
AIの実装と専門的実践における共通の影響
アラビア語のメタデータワークフローは、OCLC Researchが以前に行ったAIとメタデータ管理に関する調査から得られた、より広範な知見を裏付けるものとなりました。
まず、ハイブリッドモデルが恐らく最も効果的です。AIは効率性と拡張性を向上させることができますが、専門知識の必要性を代替するものではありません。特に言語的に複雑な環境では、人間の検証が不可欠です。OCLC Researchの以前の調査結果もこれを裏付けており、「AIの実装は人間の専門知識を代替するのではなく、強化するものとして設計することの重要性、そしてAIが大量処理や定型業務を処理する可能性を活用しつつ、専門能力開発の道筋が堅固であり続けることを保証する」と指摘しています。
第二に、システム設計において英語中心の前提から脱却する必要があります。多言語対応の知識インフラを支えるには、データ、標準規格、ワークフローといったあらゆるレベルで言語的多様性へのより深い理解が求められます。アラビア語のメタデータワークフローに関するこの観察結果は、我々の以前の調査結果で強調した内容と同様です。その調査結果では、「AIシステムは、一般的な学習データベースには含まれていないコミュニティ固有の用語や文化的ニュアンスを理解するために必要な、深い文脈的理解を欠いていることが多い」としています。
第三に、メタデータの充実化は、ますます注目を集めている分野です。多くのアラビア語コレクションには、詳細な主題メタデータが不足しています。AIは、アラビア語での件名標目、要約、キーワードの生成を支援できます。以前の調査でも、AIがメタデータの充実化にもたらす可能性について指摘しました。例えば、機関リポジトリへの登録プロセスでは、「学生や研究者がメタデータの作成を負担で時間のかかる作業だと感じるため、完全かつ正確なメタデータを提供できないことが多い」という点です。件名標目の提案や自動抄録生成といった分野でAIを活用することで、このギャップを埋めることができます。
第四に、AIはレコードの下書きや推奨事項を生成することで、滞貨の削減に貢献できる可能性があります。このユースケースは、OCLC Researchが以前に発表したAIとメタデータワークフローに関する調査結果でも強調されていました。「これらの資料についてAIが生成した簡略レコードは、ディスカバリーシステムに早期に表示されることを可能にし、隠れたコレクションの発見プロセスを加速させ、ローカルの在庫管理をサポートします。この手法は、発見に対する差し迫ったニーズに対応すると同時に、時間をかけてレコードを完成、充実、または洗練させることを可能にします。」
アラビア語のメタデータワークフローは、英語ベースのシステムとは異なる独自の機能を有しており、それがAI実装の特定のユースケースに影響を与えます。しかし、前述の例が示すように、AIを活用したメタデータワークフローに関する一般的な見解も存在し、これはアラビア語システムと非アラビア語システムの両方に等しく適用できます。おそらく最も重要なのは、AI実装を検討する際の目標は、置き換えではなく拡張であり、目録作成者が専門知識を最も価値の高い分野に集中できるように支援することであるという点です。現在の議論では、AIの導入を自動化と専門家による制御の二者択一として捉える傾向があります。しかし、この視点では狭すぎます。AIは、人間と機械の協働の連続体の一部として理解する方がより有益であり、問題はAIを使用するかどうかだけでなく、どのように、どこで、どのような制約の下で使用するかです。
今後の展望
中東の図書館では、実用的なアプローチが広まりつつあります。各機関は、特に正規化、情報拡充、翻字といった分野において、AIの応用を模索しつつ、人間の監視体制をしっかりと維持しています。
また、集団行動の機会も存在します。アラビア語の学習データセットの改善、典拠フレームワークの強化、そして機関間の連携促進は、この分野でAIを効果的に活用するために不可欠となるでしょう。
ConnexionやWorldCat Discoveryといったシステムの発展は、既に進歩が始まっていることを示しています。AIはこの取り組みを加速させることができますが、そのためには、実際のワークフローに基づき、言語的・文化的専門知識によって裏付けられたAIが必要となります。
結局のところ、これは単に効率性の問題にとどまりません。表現の問題でもあるのです。アラビア語の知識が正確に記述され、グローバルな情報検索システム内で完全に可視化されるようにすることは、依然として重要な課題であり、私たちのインフラがどれほど包括的であるかを測る有意義な試金石となります。
目次へ戻る▲
原文はこちらから>>
シリーズ: OCLCあの時この時 (11)
マイクロコンピュータがILLに革命を起こす!?
最後は43年前のOCLC Newsletter, no. 145 (Feb. 1983) からILL (Interlibrary loan=図書館間相互貸出) システム開発の話題をお送りします。
そう言えば「マイクロコンピュータ」という言葉がありましたが、現在耳にする事もほとんどありません。IT用語辞典を引くと『個人向けの小型で安価な汎用コンピュータの、1970~80年代における一般的な名称。現在では一般的に「パーソナルコンピュータ」(パソコン、PC:Personal Computer) と呼ばれる製品カテゴリーの創成期の呼称である。』とあります。『コンピュータといえば企業などの大きな組織が利用する大型汎用機 (メインフレーム) やミニコンピュータ、オフィスコンピュータなどしかなかった1970年代後半、安価なマイクロプロセッサの開発により個人が家庭で使える汎用コンピュータとしてマイクロコンピュータが登場した。』そうそう、その頃はパソコンとかPCとかいった名称がまだなかったのですね。
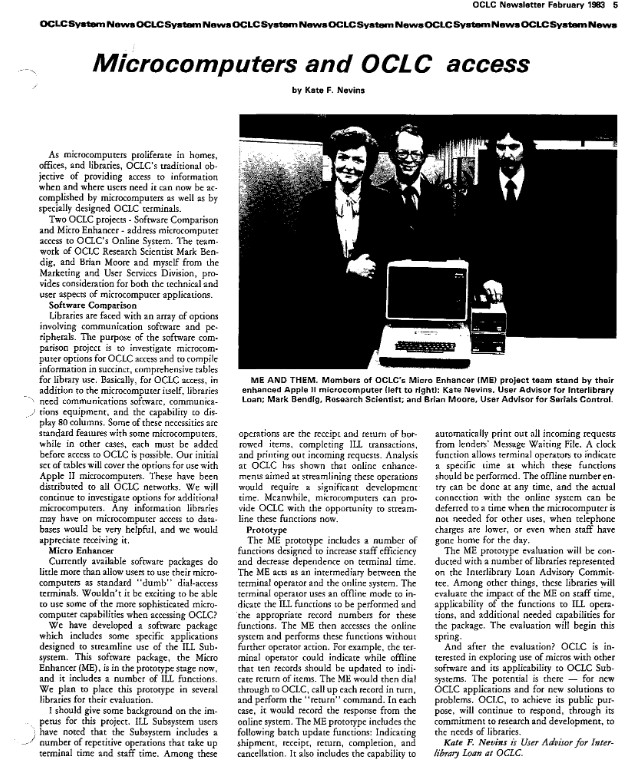
OCLC Newsletter, no. 145 (Feb. 1983)
この記事では当時OCLCで行われていた2つのプロジェクト「ソフトウェア比較」と「マイクロ・エンハンサー」が紹介されています。ちなみにこの時代、まだOCLCの利用は専用端末で行われており、汎用コンピュータでWorldCat (当時の名称 Online Union Catalog) を検索する事はできませんでした。ILLサブシステムの利用者からは、貸出資料の受領と返却、ILL取引の処理、および新規リクエストの印刷など端末の稼働時間やスタッフの時間を奪う反復的な操作が数多く含まれているとの指摘がありました。
ソフトウェア比較
ソフトウェア比較プロジェクトの目的は、OCLCへのアクセスに利用できるマイクロコンピュータの選択肢を調査し、図書館が利用するための簡潔かつ包括的な表に情報をまとめることでした。
当時、OCLCにアクセスするには、マイクロコンピュータ本体に加え、図書館には通信ソフトウェア、通信機器、および80桁の表示能力が必要でした。これらの要件の一部は、一部のマイクロコンピュータでは標準機能として備わっていましたが、そうでない場合は、OCLCへのアクセスを可能とするためにそれぞれを自分で追加する必要がありました。最初に作成した表のセットでは、Apple IIマイクロコンピュータで使用可能なオプションを取り上げ、すべてのOCLCネットワークに配布しました。
この記事ではマイクロコンピュータでデータベースにアクセスするための情報を提供してもらうよう図書館に呼び掛けています。
マイクロ・エンハンサー
当時利用できたソフトウェアパッケージは、利用者がマイクロコンピュータを標準的な「データ処理能力のない」ダイヤルアップ接続端末として使用する程度のことしかできませんでした。マイクロコンピュータのより高度な機能を活用してOCLCにアクセスできるようになったら、とても魅力的と思われたのです。
プロジェクトチームは、ILLサブシステムの利用を効率化するために設計された専用アプリケーションを含むソフトウェアパッケージを開発しました。このソフトウェアパッケージは「マイクロ・エンハンサー(ME)」と名付けられ、プロトタイプに数多くのILL機能を搭載していくつかの図書館に導入し、評価してもらう予定としています。
プロトタイプ
マイクロ・エンハンサー (以下、ME) のプロトタイプには、スタッフの業務効率を高め、端末操作に費やす時間を削減するために設計された数々の機能が搭載されていました。
端末操作を行う人はオフラインモードを使用して、実行すべきILL機能と、それらの機能に対応する適切なレコード番号を指定します。その後、MEがオンラインシステムにアクセスし、追加操作を必要とせずにこれらの機能を実行します。
例えば、端末操作者はオフライン状態で、資料の返却を示すために10件のレコード更新を指定します。すると、MEはOCLCにダイヤルアップ接続し、各レコードを順番に呼び出して、「返却」コマンドを実行します。その都度、オンラインシステムからの応答を記録します。MEのプロトタイプには、発送、受領、返却、完了、およびキャンセルの指定といったバッチ更新機能が含まれていました。
また、貸し手側の「メッセージ待機ファイル」から受信したすべてのリクエストを自動的に印刷する機能も備えていました。タイマー機能により、端末操作者はこれらの機能を実行する具体的な時刻を指定、オフラインでの番号入力はいつでも行うことができ、オンラインシステムとの実際の接続は、マイクロコンピュータを他の用途で使用する必要がない時間帯、電話料金が安くなる時間帯、あるいはスタッフが帰宅した後など、都合の良い時間にセットすることが可能でした。
その後、マイクロ・エンハンサー(ME)は目録用Cataloging Micro Enhancer (CAT ME、その後CAT ME Plus) も開発され、ILL用と同様にオフラインでのバッチ検索、データ編集、所蔵登録などを行いました。その後継サービスがConnexionやRecord Managerです。ILLはWorldShareのプラットフォームでのサービスに進化しています。
インターネットが登場する前のこの時代、電話回線使用料が1分いくらでかかるため、時計を気にしながら極力オフラインでの作業を行っていたのでした。
それから40数年、思えば技術は目まぐるしく進歩したものですが、こういった過去の努力や知見が現在のWorldShare ILLや目録アプリケーションでも生かされているのです。
目次へ戻る▲
OCLC Newsletter, no. 145 (Feb. 1983) の該当ページはこちらから>>
(OCLC事業部)
掲載の商品・サービスに関するお申し込み・お問い合わせ先
株式会社紀伊國屋書店 OCLC事業部
電話:03-6910-0514 e-mail:oclc@kinokuniya.co.jp